Конвертер PDF в TXT онлайн
Бесплатно, до 50 файлов сразу, на компьютере и телефоне — без загрузки на сервер
Перетащите файлы сюда или вставьте из буфера (Ctrl+V). Принимаем PDF — до 50 файлов за раз.
Файлы не загружаются на сервер
Извлечение текста из PDF нужно, когда содержимое требуется не читать, а использовать: перенести в редактор, найти нужный фрагмент, прогнать через поиск, скопировать цитату из большого документа.
Инструмент разбирает документ в браузере и собирает текст постранично, помечая границы страниц. Ни одна страница не передаётся на сервер.
Чего инструмент не делает
Он не распознаёт текст на изображениях. Если PDF — это фотографии или сканы страниц, текстового слоя в нём нет, и никакой разбор его не найдёт. В таком случае инструмент сообщит об этом прямо, а не вернёт пустой файл без объяснений.
Он также не восстанавливает вёрстку: таблицы и колонки в простом тексте неизбежно теряют структуру.
Как пользоваться
- 1Добавьте PDF-документ.
- 2При необходимости укажите диапазон страниц.
- 3Нажмите «Конвертировать».
- 4Скачайте текстовый файл — он сохраняется в UTF-8 и открывается в любом редакторе.
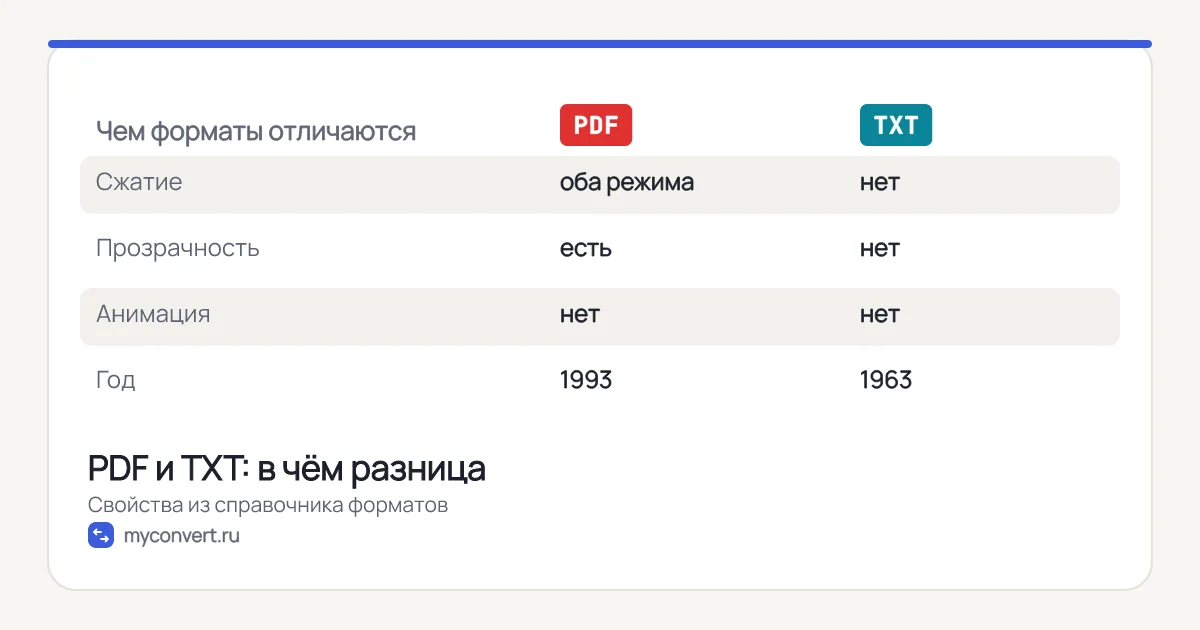
PDF и TXT: в чём разница
Таблица помогает понять, что изменится после конвертации и не потеряете ли вы что-то важное.
| Параметр | TXT | |
|---|---|---|
| Полное название | Portable Document Format | Plain Text |
| Разработчик | Adobe, с 2008 года открытый стандарт ISO 32000 | не имеет единого владельца, восходит к таблице ASCII |
| Год появления | 1993 | 1963 |
| Сжатие | С потерями и без | Без сжатия |
| Прозрачность | Да | Нет |
| Анимация | Нет | Нет |
| Глубина цвета | зависит от вложенных изображений, поддерживает CMYK и цветовые профили | неприменимо |
| Поддержка браузерами | Все браузеры | Все браузеры |
| Где встречается | Договоры, счета, резюме, сканы документов, инструкции, электронные книги | Заметки, логи, выгрузки, исходные тексты |
Частые вопросы
Из любого ли PDF можно извлечь текст?
Почему результат пустой, хотя текст на страницах виден?
Сохранится ли форматирование?
Как разделены страницы?
Почему файл начинается со странного символа?
О форматах
Статьи по теме
- Кракозябры вместо русского текста — почему и как исправитьОткуда берутся нечитаемые символы в TXT и CSV, чем windows-1251 отличается от UTF-8, почему Excel открывает выгрузку неправильно и как это чинится.
- Как уменьшить размер PDF, чтобы уложиться в лимит загрузкиПочему сканы весят десятки мегабайт, чем отличаются режимы сжатия PDF, что происходит с текстом и как уложиться в лимит формы без потери читаемости.